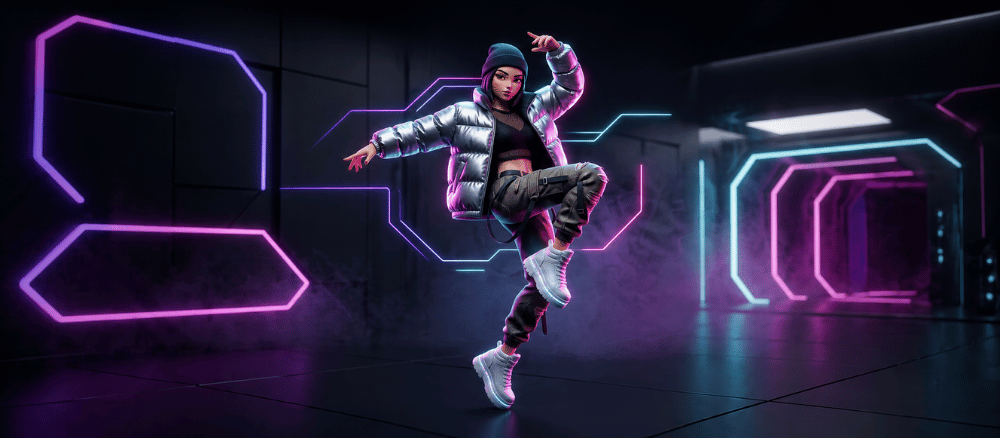
如何用 ImagineToVideo 制作漂亮的韩舞视频:ChatGPT + Seedance 2.0 完整教程
K-pop 舞蹈翻跳视频每天在 TikTok、YouTube Shorts、抖音上刷屏 —— 但直到最近,做一条这样的视频要么得真的去学完整段编舞,要么得找干净的拍摄场地、拉朋友帮你掌镜。如果你能反过来呢?自己设计一个跳舞的角色 —— 一个完全按你审美捏出来的 3D 风格少女,让她在三分钟内、用大约一杯奶茶的钱,跳完一整段 K-pop 编舞?
这正是这篇教程要拆解的事。读完之后,你会拿到我们在 ImagineToVideo 自己用的完整双模型工作流:先用 ChatGPT(或 GPT Image) 设计角色和分镜参考图,再用 ImagineToVideo 内置的 Seedance 2.0 让她真的动起来。这套方法的灵感正是过去一个月在韩国 Threads 上疯传的「16 宫格 K-pop 舞蹈分镜」—— 那种 4×4 网格图把一段舞拆成 16 帧关键 pose,每格都标好韩文动作名和运动箭头,告诉模型"她应该这样动"。
我们这次实战用的就是这种 16 宫格分镜图:

而这是用 Seedance 2.0 把上面的分镜变成真正会动的成片:
<video src="https://cdn.imaginetovideo.com/blog/Korean%20dance%20routine.mp4" controls style="max-width: 480px; width: 100%; display: block; margin: 1.5rem auto;"></video>
关于本系列。 这是 ImagineToVideo 视频生成教程系列 的 第 1 篇 —— 我们会用一篇拆一个具体创作场景,从 prompt 写到成片下载,全程基于 ImagineToVideo 内置模型。后续会陆续覆盖产品 hero 镜头、宠物拟人化短片、带原生音频的对话场景等等。
为什么 ChatGPT + Seedance 是韩舞视频的最优组合
ChatGPT 和 GPT Image 真正擅长的是 角色一致性。给它一张基础肖像 + 一段结构化 prompt,它能在 16 个不同舞蹈动作里渲染同一个角色,脸不会跑、衣服不会变。这件事在 2024 年之前是个硬骨头,要么训 LoRA、要么 PS 一帧帧画。现在一次 prompt 就能搞定。
但它做不到的事,就是让画面动起来。GPT Image 的输出永远是一张静态网格图。
让这套工作流在 2026 年真正可用的,是第二类模型:参考图驱动视频(reference-to-video,简称 R2V)。你喂它一张或几张参考图 + 一段动作描述 prompt,它生成一段尊重参考图的视频。ImagineToVideo 集成了两个:
- Seedance 2.0 —— 支持最多 9 张参考图,可生成 5 到 15 秒、720p 视频,5 秒片段约 0.85 美元。本文主推 就是它,因为便宜到可以反复试,编舞不对就重抽。
- Kling V3 Omni —— 支持最多 7 张参考图 + 原生音频 + 多镜头,但 5 秒要 13 美元。等你把动作锁定了再升级到它,加配乐或上 4K。
下面整篇文章走 Seedance 路线,结尾会讲什么时候该升级到 Kling。如果你想直接做院线级 4K 韩舞 MV,我们有专门的 Kling 4K Mode 教程。
Step 1 — 在 ChatGPT 里设计你的舞者(16 宫格分镜)
打开 ChatGPT(开启图像生成的版本,或者直接用 GPT Image)。先上传一张你想让她跳舞的角色基础肖像图 —— 一张干净的正面 3D 风格插画效果最好。如果你还没有,先让 ChatGPT 生成一张:"3D-rendered cartoon portrait of a young woman with curly brown hair, round glasses, white cardigan over a purple dress, teal sneakers, neutral background, Pixar concept-art style."
拿到肖像图之后,用这段 prompt 生成 16 宫格舞蹈分镜:
3D-rendered K-pop dance reference sheet, 4×4 grid layout, 16 panels total.
[CHARACTER] Use the uploaded portrait. Same face, same outfit, same hair across
all sixteen panels — do not redesign the character.
[PANEL STRUCTURE — per cell]
  Top-left: bold number badge (1–16) + short pose title in Korean or English
  Center: full-body dance pose illustration
  Bottom-left: 3–4 line description of the motion
  Overlay: directional motion arrows (curved, straight, or rotational)
[CHOREOGRAPHY] Sixteen sequential moves of a K-pop / hip-hop routine: warm-up
pose, rhythm bounce, smooth body wave, footwork start, hip-hop sequence
(panels 5–16), wave moves, popping moves, footwork steps. End on a confident
closing pose.
[STYLE] High-detail 3D-sculpted render, soft studio lighting, subtle shadows,
clean linework, K-pop choreography illustration quality.
[COLOR] Grayscale shading, no color tones.
[NEGATIVE] No background scenery, no extra characters, no color, no logos.
[OUTPUT] At least 1024×1024 final resolution. 2048×2048 if available.
prompt 里有两处细节非常关键,千万不要删:
「same face, same outfit」这一行。 不写明的话,ChatGPT 渲染到第 7 格附近会自作主张把开衫重新设计 —— 它看到 prompt 里有"wave move"就会觉得衣服该有飘逸感。一定要明确告诉它:角色是固定的,不准重新设计。
「输出 1024+ 分辨率」这一条。 这一条直接关系到 Step 3 能不能跑通。ImagineToVideo 的 Seedance R2V 接口会拒绝小于 640×640 像素的参考图,返回一个不可重试的错误,生成根本不会启动。ChatGPT 默认输出有时只有 768×768,所以 prompt 里强制 1024+ 是为了避免后面被拒。
跑完之后,你会拿到一张 4×4 网格图,你设计的角色用 16 个连续 pose 跳完一段 K-pop 编舞 —— 就像本文开头那张一样。
Step 2 — 把关键帧裁出来(或者整张直接用)
现在你手上有一张 16 宫格图。喂给 Seedance 有两种方式:
整张当作单一参考图喂进去。 适合你想让模型抓"角色风格" —— 身材比例、配色、渲染质感 —— 而不是某个具体动作顺序。把整张网格图丢进 reference 区,让模型自己在 16 个 pose 里挑重点。
裁切 1 到 4 张关键帧。 适合你想要一个具体的舞蹈动作序列。挑出起始 pose、收尾 pose、再加一两张中段过渡帧。在 Photopea、Figma、或浏览器里任何裁图工具里裁出来(macOS 上我直接用 Preview,省事)。每张裁出来的图至少 640×640,安全起见导出 1024+。
我们这次用的是裁切方式:选了第 1、5、11、16 格 —— 起手 pose、wave 入场、hip-hop 中段、收尾步法。4 张参考图是甜点区。我们测过,1 张参考图模型自由度太大、容易跑偏;9 张全塞进去结果会变成生硬的翻页画册而不是流畅编舞。
Step 3 — 在 Seedance 2.0 上让她真的动起来
激动的环节到了。打开 Seedance 2.0 生成页,或者从 Seedance 落地页 点 Try Now。
把裁好的 1 到 4 张参考图上传到 reference 区。UI 会显示每张图的缩略图。如果哪张被打回来"pixel count too low"错误,说明那张图小于 640×640,回去重新导出更高分辨率即可。
prompt 输入框 支持 2000 字符,对一个完整的镜头描述来说绰绰有余。韩舞场景下推荐这个结构:
[CHARACTER] {{把 ChatGPT 那边的角色描述粘过来}}
[ACTION] A young woman in a white cardigan and purple dress performs a
K-pop / hip-hop dance routine. She starts in a neutral standing pose,
transitions through a smooth body wave, lowers her center of gravity into
hip-hop footwork with crossed legs, and finishes in a confident closing pose.
Smooth, energetic, on-beat motion.
[CAMERA] Static medium shot, eye level, slight handheld micro-movement.
[STYLE] 3D-rendered, cinematic studio lighting, neutral seamless backdrop,
K-pop music video aesthetic.
[DURATION] 5 seconds.
实战跑过几十次之后,几条调参经验:
分辨率:直接选 720p。 Seedance 提供 480p 和 720p。480p 只适合第一轮试错 —— 这个尺度下角色脸会糊。720p 是短视频甜点区。如果最终想要 4K 韩舞 hero 视频,正确路径是:先用 720p Seedance 把动作锁定,然后把锁定的 prompt 在 Kling V3 4K 模式 重抽。
时长:从 5 秒起步。 Seedance 支持 5、8、10、12、15 秒。时长越长积分越贵,模型也越容易跑偏。5 秒足够验证编舞是否到位;确认 OK 之后,用相同 prompt 和参考图重抽 8 或 10 秒的完整版。
迭代用 Seedance 2.0 Fast 版。 ImagineToVideo 上 Seedance 有两档:质量版和快速版。快速版便宜 25–40%、出片更快,对参考图驱动的短片来说画质几乎看不出差别。我们的工作流是:所有迭代试错都用 Fast 版,只有最终发 TikTok / Shorts 的成片才切到质量版。
这条片子的总成本:约 0.85 美元。如果用 Fast 版,能再降到 0.65 美元上下。作为对比:找一个 3D 动画师手动绑骨 + 制作 5 秒角色舞蹈循环,起步价超过 400 美元。
Step 4 — 什么时候该升级到 Kling V3 Omni(要配乐 / 要 4K)
Seedance 能搞定大约 80% 的韩舞视频需求。剩下 20% 的情况下,应该上 Kling V3 Omni:
- 需要配乐 / 人声同步舞蹈节拍。 Seedance 输出是无声视频。Kling V3 Omni 一次生成时同时输出视频 + 原生音频 —— 包括环境声、音效、以及(写好 prompt 的话)跟动作匹配的节奏点。如果你想要一条已经混好节拍的完整韩舞 clip,那是 Kling 的活。
- 需要多镜头切换。 Kling V3 Omni 单次生成里支持最多 6 个连续机位,且角色在切镜之间保持身份一致。Seedance 是单镜头的。一段 30 秒带三次机位切换的 K-pop verse,用 Kling 一次出齐,不用拼 6 段 Seedance。
- 需要真 4K。 Kling 的 1080p 模式底层走 "pro 模式",原生输出 3840×2160。Seedance 上限 720p。要做电视广告、品牌活动、或者要投到大屏的韩舞 hero,4K 升级值这个钱。
5 秒片段价格对比:
| 模型 | ~5 秒成本 | 适合的韩舞场景 |
|---|---|---|
| Seedance 2.0 Fast ⭐ | ~0.75 美元 | 迭代试错、短视频、抛弃式实验 |
| Seedance 2.0 Quality | ~0.85 美元 | 最终成片,发 TikTok / Shorts |
| Kling V3 | ~8.84 美元 | 多镜头编舞、1080p 交付 |
| Kling V3 Omni | ~13.41 美元 | 多参考图 + 原生音频(完整韩舞 clip) |
| Kling 4K Mode | ~25–30 美元 | 大屏、MV hero、电影节投递 |
加粗那两栏就是这套工作流的默认位置。 Kling 那几栏是动作锁定之后才考虑的升级路径。
→ 试 Kling V3 image-to-video(V3 标准版、V3 Omni、新 4K Mode 共用入口)
同一段韩舞参考图,三个模型表现对比
我们把同一组韩舞参考图喂给 ImagineToVideo 上的三个模型跑了一轮。短结论:
- Seedance 2.0 质量版:5 秒里角色身份保持得最稳,脸不跑、动作干净。本文上面那段视频就是它出的。
- Kling V3 Omni:画面更电影感 —— 灯光更立体、纵深感更好 —— 但同样 5 秒成本是 Seedance 的 15 倍,对韩舞这个场景来说不值。除非你需要它独有的能力(同步配乐、多镜头、4K)。
- Kling V3 标准版:直接淘汰。标准版根本不接受参考图(只支持首末帧),多参考图工作流不能用。要 Kling 系列就必须 Omni。
结论:在「ChatGPT 16 宫格 → 韩舞视频」这个具体场景里,Seedance 不只是便宜的选择,它就是对的选择。Kling V3 Omni 是当交付要求碾压成本的时候才上的升级。
5 个常见坑(以及怎么避开)
跑了大约 200 次韩舞和嘻哈舞蹈之后,最常见的失败模式:
1. 参考图分辨率不够。 这是头号被拒原因。ImagineToVideo 把 Seedance R2V 的"像素数过低"错误归类为不可重试 —— 你的积分不会被扣,但生成根本不会启动。解决:所有参考图最低 1024×1024 重导出。
2. 角色在 16 格之间漂移。 ChatGPT 不被强约束的话,第 7 格附近会偷偷把开衫重新设计。永远在分镜 prompt 里写明"same face, same outfit, same hair, do not redesign"。如果还是漂移,先单独生成基础肖像,再把那张图作为锁定参考喂进分镜 prompt。
3. Prompt 太短。 R2V 模型把 prompt 当作编舞规格书。"Dance"得到的是泛泛舞蹈。"Hip-hop body wave transitioning into crossed-leg footwork, static medium shot, eye level, neutral backdrop, on-beat" 才能得到你真想要的东西。瞄准 100–200 字。
4. 想一步到位 4K。 这是浪费积分。先在 720p Seedance 反复迭代,直到动作锁定,再升级到 Kling 4K Mode 出最终成片。不要拿高价积分去验证一个还没调对的 prompt。
5. 画幅比错了。 如果交付目标是 9:16 竖屏(TikTok、Reels、Shorts,绝大多数韩舞内容是这格式),从一开始就生成 9:16。模型是按目标画幅构图的;横屏 16:9 生成完再裁竖屏,几乎必然把舞者的头或脚切掉。
TL;DR — 三步搞定你的韩舞视频
- ChatGPT / GPT Image —— 生成 16 宫格 K-pop 舞蹈分镜,1024+ 分辨率,明确写「same face, same outfit」锁定角色。
- 裁切 —— 选出 1 到 4 张关键 pose(起始、过渡、收尾),每张 ≥ 640×640。
- Seedance 2.0 —— 进 /seedance,写一段 100–200 字结构化编舞 prompt,720p / 5 秒。约 1 美元、3 分钟一条。
需要配乐、多镜头、或真 4K 时升级到 Kling V3 Omni。否则韩舞工作流就在 Seedance 里。
→ 在 Seedance 2.0 做你的第一条韩舞视频 → 或者直接上 Kling V3 image-to-video(要配乐 + 4K)
如果你的最终交付是大屏或广电级,需要原生 3840×2160 起步,Kling 4K Mode 教程 专门讲这条路径 —— 我们的 4K AI 视频生成器落地页 是最快的入口。
系列下一篇预告
这是 ImagineToVideo 视频生成教程系列 的 第 1 篇。后续将覆盖:
- 第 2 篇 —— 宠物肖像动画:一张照片让你的狗主演一段电影感短片,用 Seedance 搞定。
- 第 3 篇 —— 电商产品 hero 镜头:3D 旋转 + 微距特写,广电画质给电商用。
- 第 4 篇 —— Kling V3 Omni 原生音频对话场景(带嘴型同步 + 房间环境声)。
- 第 5 篇 —— 9:16 竖屏一镜到底叙事短片:从一张角色参考图直出 TikTok 故事 clip。
订阅博客或下周回来看第 2 篇。如果你有具体想看到的场景,告诉我们。
现在去让你的舞者动起来吧。