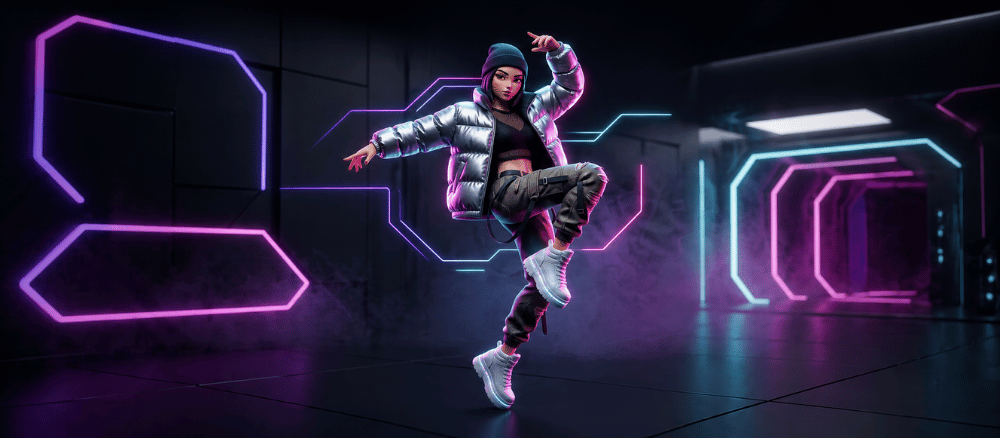
如何用 AI 製作精美的 K-Pop 舞蹈影片 —— ImagineToVideo 完整教學
每天都有大量 K-Pop 翻跳影片湧入 TikTok 與 YouTube Shorts —— 而在不久之前,想做一支這樣的影片,你得真的把編舞學起來、找一個乾淨的拍攝場地,再拜託朋友幫你舉相機。但如果換個做法:你可以自己設計一位舞者 —— 一個外型完全依你想像打造的 3D 風格角色 —— 讓她在大約三分鐘內、花上約一美元,完整跳完一段 K-Pop 舞蹈呢?
這正是本篇教學要帶你走完的流程。讀完之後,你會掌握我們在 ImagineToVideo 使用的完整雙模型工作流:先用 **ChatGPT(或 GPT Image)**設計角色與動作分鏡表,再用 ImagineToVideo 上的 Seedance 2.0 讓她真正動起來。這套技巧,就是過去一個月在韓國創作者 Threads 上瘋傳的 16 格 K-Pop 舞蹈參考圖背後的方法 —— 那些格狀圖會一格一格清楚標示角色該做什麼動作。
以下是我們全文會使用的參考圖範例:

而這是最終成果 —— 同一個角色,現在真的跳起舞來了:
<video src="https://cdn.imaginetovideo.com/blog/Korean%20dance%20routine.mp4" controls style="max-width: 480px; width: 100%; display: block; margin: 1.5rem auto;"></video>
關於本系列。這是 ImagineToVideo 影片生成教學 的第 1 篇 —— 這是一個實作導向的系列,每篇會以 ImagineToVideo 內建的模型,完整走過一個特定的創作情境,從提示詞一路到成品。後續主題將涵蓋產品主視覺鏡頭、寵物肖像動畫、帶原生音訊的電影感對話場景等等。
為什麼 ChatGPT + Seedance 是 K-Pop 舞蹈影片的最佳組合
ChatGPT 與 GPT Image 最擅長的,是角色一致性。給模型一張基礎人像與結構化的提示詞,它就能在十六個不同的舞蹈動作中畫出同一個人,而臉不會走樣。這其實是個難題。在 2024 年以前,你得靠 LoRA 訓練或在 Photoshop 裡手繪來解決。現在一次就能搞定。
但它們做不到的是:讓畫面動起來。輸出永遠是一張靜態格狀圖。
讓這套工作流在 2026 年可行的,是第二類模型:參考圖生影片(R2V)。你餵給它一張或多張參考圖,加上動作提示詞,它就會生成一支忠於參考圖的影片。ImagineToVideo 整合了其中兩款:
- Seedance 2.0 —— 支援最多 9 張參考圖,可生成 5–15 秒的 720p 影片,五秒片段約 $0.85。這是我們推薦用來做 K-Pop 舞蹈影片的模型,便宜到你可以反覆調整,直到編舞看起來對味。
- Kling V3 Omni —— 支援最多 7 張參考圖,還有原生音訊與多鏡頭串接,但五秒片段約 $13。留到最後一版再用:當你需要音樂與舞蹈同步,或要交付真正的 4K 時。
本文其餘部分走的是 Seedance 路線,接近尾聲會有一段 Kling 升級說明。如果你想要這套流程的電影級原生 4K 版本,我們另有一篇 Kling 4K Mode 指南。
步驟 1 —— 在 ChatGPT 裡設計你的舞者(16 格分鏡表)
打開 ChatGPT(啟用圖像生成的版本,或直接使用 GPT Image)。上傳一張你想讓她跳舞的角色基礎人像 —— 乾淨的正面 3D 風格插畫效果最好。如果手邊沒有,可以先請 ChatGPT 生成一張:「3D 渲染卡通風格人像,年輕女性,棕色捲髮,圓框眼鏡,白色開襟衫搭紫色洋裝,藍綠色球鞋,中性背景,Pixar 概念美術風格。」
接著貼上這段舞蹈分鏡表的提示詞:
3D-rendered K-pop dance reference sheet, 4×4 grid layout, 16 panels total.
[CHARACTER] Use the uploaded portrait. Same face, same outfit, same hair across
all sixteen panels — do not redesign the character.
[PANEL STRUCTURE — per cell]
  Top-left: bold number badge (1–16) + short pose title in Korean or English
  Center: full-body dance pose illustration
  Bottom-left: 3–4 line description of the motion
  Overlay: directional motion arrows (curved, straight, or rotational)
[CHOREOGRAPHY] Sixteen sequential moves of a K-pop / hip-hop routine: warm-up
pose, rhythm bounce, smooth body wave, footwork start, hip-hop sequence
(panels 5–16), wave moves, popping moves, footwork steps. End on a confident
closing pose.
[STYLE] High-detail 3D-sculpted render, soft studio lighting, subtle shadows,
clean linework, K-pop choreography illustration quality.
[COLOR] Grayscale shading, no color tones.
[NEGATIVE] No background scenery, no extra characters, no color, no logos.
[OUTPUT] At least 1024×1024 final resolution. 2048×2048 if available.
這段提示詞裡有兩個細節真的很關鍵,不要拿掉:
**「same face, same outfit」這一句。**少了它,ChatGPT 會在第 7 格左右悄悄把開襟衫重新設計一次,只因為提示詞裡出現了「wave move」。你必須明確告訴它,角色是固定的。
**1024 以上的輸出解析度。**這在步驟 3 會派上用場。ImagineToVideo 的 Seedance R2V 端點會拒絕小於 640×640 像素的參考圖 —— 它會回傳一個無法重試的錯誤,生成根本不會開始。ChatGPT 的預設圖像輸出有時只有 768×768 左右;在提示詞裡要求 1024 以上就能避開被拒絕。
現在你手上應該有一張 4×4 格狀圖,呈現你的舞者依序完成十六個 K-Pop 動作 —— 就像本文開頭那張一樣。
步驟 2 —— 裁切出關鍵舞蹈畫面(或不裁也行)
你現在有一張 16 格的圖。要餵給 Seedance 有兩種方式,各有用途:
**整張格狀圖當成單一參考圖。**適合你希望輸出捕捉角色風格的情況 —— 身形比例、配色、渲染質感 —— 而不是特定的動作順序。把整張圖丟進參考圖欄位,讓模型自行決定要強調哪些動作。
**裁切出一到四格關鍵畫面。**適合你想要特定順序的特定舞蹈段落。挑出起始動作、結束動作,再加一兩個中段畫面。用 Photopea、Figma 或任何瀏覽器內的編輯器裁切即可(我們大多時候其實就用 macOS 的「預覽程式」)。每張裁切圖至少要 640×640 —— 保險起見,重新輸出成 1024 以上。
本文這段舞蹈,我們裁了第 1、5、11、16 格 —— 熱身動作、body wave 起手、hip-hop 中段,以及收尾腳步。依我們的測試,四張參考圖是最佳甜蜜點。只給一張,模型自由度太高;給到九張,輸出會開始像翻頁動畫,而不是流暢的一段舞。
步驟 3 —— 在 Seedance 2.0 上讓她動起來
好戲登場。打開 Seedance 2.0 生成器(或前往 Seedance 主頁並點擊 Try Now)。
在參考圖面板中,上傳你裁好的 1–4 張圖。介面會在接受後顯示各張縮圖。如果有任何一張因為「像素數過低」被拒絕,代表那張參考圖不到 640×640 —— 用更高解析度重新輸出後再上傳一次。
提示詞欄位有 2000 字元上限,足夠寫完整段鏡頭描述。貼上結構化的內容。以下是適用於 K-Pop 舞蹈的寫法:
[CHARACTER] {{copy the character description from your ChatGPT sheet}}
[ACTION] A young woman in a white cardigan and purple dress performs a
K-pop / hip-hop dance routine. She starts in a neutral standing pose,
transitions through a smooth body wave, lowers her center of gravity into
hip-hop footwork with crossed legs, and finishes in a confident closing pose.
Smooth, energetic, on-beat motion.
[CAMERA] Static medium shot, eye level, slight handheld micro-movement.
[STYLE] 3D-rendered, cinematic studio lighting, neutral seamless backdrop,
K-pop music video aesthetic.
[DURATION] 5 seconds.
這套流程我們跑過幾十次,以下是幾個調校心得:
**解析度:就用 720p。**Seedance 提供 480p 與 720p。480p 只適合第一輪試跑 —— 在這個尺寸下,角色的臉會開始糊掉。720p 是短影音的最佳解。如果你之後想要 4K 的 K-Pop 主打影片,正確做法是先用 Seedance 在 720p 把編舞調到位,再把定案的提示詞丟到 Kling V3 並開啟 4K 選項重跑一次。
**時長:從 5 秒開始。**Seedance 支援 5、8、10、12、15 秒。時間越長,點數消耗成比例增加,模型也有更多空間走偏。五秒足以驗證舞蹈是否傳達正確;確認之後,用同樣的提示詞與參考圖重新生成 8 或 10 秒的完整版本。
**用 Seedance 2.0 Fast 做迭代。**ImagineToVideo 提供兩種 Seedance 等級:品質版與快速版。快速版便宜 25–40%、速度明顯更快,而在短的參考圖驅動片段上,成果幾乎看不出差別。我們所有迭代都用 Fast,只有要上 TikTok 或 YouTube 的定案成品才切到品質版。
那支片段的總成本:約 $0.85。用 Seedance Fast 可以壓到 $0.65 左右。相較之下,請 3D 動畫師綁定骨架並製作一段五秒的角色舞蹈循環,起跳價就在 $400 以上。
→ 用 Seedance 2.0 做出你自己的 K-Pop 舞蹈影片
步驟 4 —— 需要音樂或 4K 時,升級到 Kling V3 Omni
在約 80% 的 K-Pop 舞蹈影片專案中,Seedance 都是正確答案。剩下 20% 該改用 Kling V3 Omni 的情況:
- 你需要與舞蹈同步的音樂或人聲。Seedance 生成的是無聲影片。Kling V3 Omni 則能在同一次生成中同時輸出影片與原生音訊 —— 包含環境音、音效,以及(配合適當提示詞)與動作對齊的音樂節點。如果你想要一支已經混好節拍的完成品 K-Pop 片段,那就是 Kling。
- **你需要多鏡頭串接。**Kling V3 Omni 在單次生成中支援最多 6 個連貫鏡頭,且跨剪接維持角色一致性。Seedance 只支援單鏡頭。若要做一段有三次角度切換的 30 秒 K-Pop 主歌,用 Kling 一次生成,好過拼接六段 Seedance 輸出。
- **你需要真正的 4K。**Kling 的 1080p 模式在內部會對應到「pro」模式,生成原生 3840×2160。Seedance 上限是 720p。若要用於電視播出、品牌廣宣,或是要在比手機更大的螢幕上播放的 K-Pop 主打影片,這筆升級值得。
五秒片段的成本比較:
| 模型 | 約 5 秒成本 | 最適合的 K-Pop 舞蹈用途 |
|---|---|---|
| Seedance 2.0 Fast ⭐ | ~$0.75 | 迭代、短影音、可拋棄的測試 |
| Seedance 2.0 Quality | ~$0.85 | 上 TikTok / Shorts 的定案成品 |
| Kling V3 | ~$8.84 | 多鏡頭舞段、1080p 交付 |
| Kling V3 Omni | ~$13.41 | 多參考圖 + 原生音訊(完整 K-Pop 片段) |
| Kling 4K Mode | ~$25–30 | 電視播出、主打音樂影片、影展版本 |
粗體的兩列是這套工作流的預設落點。Kling 那幾列,是編舞定案之後才去的地方。
→ 試試 Kling V3 圖生影片(V3 標準版、V3 Omni 與全新 4K 模式的入口)
三款模型在同一組 K-Pop 參考圖上的表現比較
我們把完全相同的韓國舞蹈參考圖,丟進 ImagineToVideo 上三款相關模型跑了一遍。簡短結論:
- Seedance 2.0 Quality 在完整五秒內維持角色一致性的表現最佳。臉還是那張臉,舞蹈也讀得懂。上面嵌入的那支就是它。
- Kling V3 Omni 畫面稍微更有電影感 —— 打光更好、層次更深 —— 但價格是 15 倍,而在這個特定用途上並排比較,成果並沒有好上 15 倍。若你需要它的特定優勢(同步音樂、多鏡頭、4K),才值得。
- Kling V3 標準版表現吃力,因為標準等級完全不接受參考圖 —— 只支援首/末影格輸入。對這種多參考圖的 K-Pop 工作流來說,根本無法起步。請改用 V3 Omni。
結論是:針對「從 ChatGPT 分鏡表做 K-Pop 舞蹈」這套特定流程,Seedance 不只是便宜的選項,而是正確的選項。Kling V3 Omni 則是當交付需求真的要求時,你才升級過去的選擇。
五個常見陷阱(以及如何避開)
我們為 K-Pop 與 hip-hop 舞蹈片段跑過這套流程大概兩百次,以下是最常見的失敗模式:
**1. 參考圖太小。**這是被拒絕的頭號原因。ImagineToVideo 把 Seedance R2V 的像素數錯誤視為不可重試 —— 你的點數不會被扣,但生成根本不會開始。解法:每張參考圖都以至少 1024×1024 重新輸出。
**2. 各格之間角色走樣。**如果你不釘死角色,ChatGPT 會在第 7 格左右悄悄重新設計服裝。分鏡表提示詞裡一定要加上「same face, same outfit, same hair, do not redesign」。若還是走樣,先單獨生成基礎人像,再把那張圖當成固定參考餵進分鏡表提示詞。
**3. 提示詞太短。**參考圖生影片的模型會把提示詞當成編舞規格書。寫「dance」你只會得到通用的跳舞。寫「hip-hop body wave transitioning into crossed-leg footwork, static medium shot, eye level, neutral backdrop, on-beat」,你才會得到真正想要的東西。目標是 100–200 字。
**4. 想一次到位直接做 4K。**這是在浪費點數。先用 720p 的 Seedance 反覆迭代到舞蹈定案,然後再升級到 Kling 4K Mode 做最終成品。別拿高價點數去驗證一個還沒調對的提示詞。
**5. 長寬比不符。**如果交付格式是 9:16 直式(TikTok、Reels、Shorts —— 大多數 K-Pop 舞蹈內容都是),一開始就用 9:16 生成。模型會依照畫框構圖;想把 16:9 橫式成果最後裁成直式,幾乎一定會在動作進行中切掉舞者的頭或腳。
懶人包 —— 三步驟完成你的 K-Pop 舞蹈影片
- ChatGPT / GPT Image —— 以 1024 以上解析度生成 16 格 K-Pop 舞蹈參考圖,並明確釘死「same face, same outfit」。
- 裁切 —— 挑出 1–4 格關鍵舞蹈畫面(起始、中段、收尾動作),每張 ≥640×640。
- Seedance 2.0 —— 前往 /seedance,寫一段 100–200 字的結構化編舞提示詞,以 720p/5 秒生成。每支片段約 $1、三分鐘。
當你需要同步音樂、多鏡頭舞段或真正的 4K 交付時,再升級到 Kling V3 Omni。否則,這套 K-Pop 工作流就待在 Seedance 上。
→ 在 Seedance 2.0 開始你的第一支 K-Pop 舞蹈影片 → 或直接跳到 Kling V3 圖生影片,取得音樂 + 4K
如果你的最終交付是電視播出或大螢幕用途,且一開始就想要原生 3840×2160,Kling 4K Mode 指南專門帶你走這條路 —— 而我們的 4K AI 影片生成器頁面則是最快的入口。
本系列接下來的內容
以上是 ImagineToVideo 影片生成教學 的第 1 篇。接下來預告:
- 第 2 篇 —— 寵物肖像動畫:用一張照片與 Seedance,把你的狗變成一支電影感短片。
- 第 3 篇 —— 產品主視覺鏡頭:為電商生成播出級的 3D 旋轉與微距細節片段。
- 第 4 篇 —— 用 Kling V3 Omni 原生音訊製作電影感對話場景(對嘴 + 空間音)。
- 第 5 篇 —— 直式 9:16 敘事短片:從單一角色參考圖,做出可直接上 TikTok 的完整故事片段。
訂閱本部落格,或下週回來看下一集。如果你有特別想看我們示範的應用情境,歡迎來信告訴我們。
現在,讓你的舞者動起來吧。