Gemini Omni 上线:Google 首款"任意输入"AI 模型,先从视频开始(2026 发布深度解读)
Draft — 简体中文版 Slug:
google-gemini-omni-multimodal-ai-video-modelTarget: 与英文版等量 Status: first draft, ready for review. Cover:https://cdn.imaginetovideo.com/blog/cover/gemini-omni-flash.png原始来源:blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-omni/、deepmind.google/models/gemini-omni
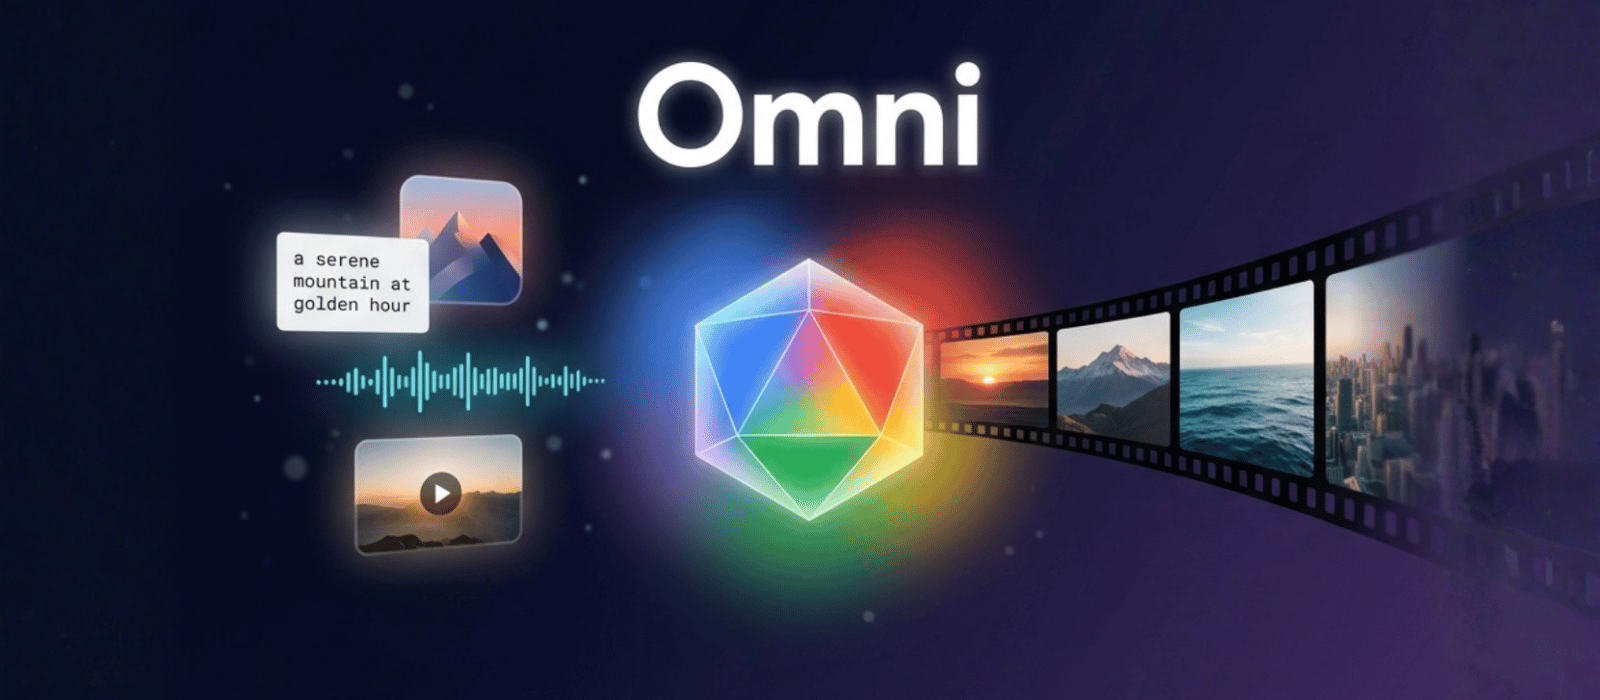
2026 年 5 月 19 日,Google DeepMind 悄悄上线了一个会让此前所有"AI 视频生成器"对比文章都需要重写的模型。Gemini Omni——以及首个发布的变体 Gemini Omni Flash——不是把视频模型缝在 chat 模型上的拼装产物。它是一个单一架构,接受任意输入模态(文本、图像、视频、音频),生成输出模态——现在先支持视频,图像和音频"假以时日"加入。
Google DeepMind CTO Koray Kavukcuoglu 在发布博客里用一句话定义了它:"Omni 是我们的新模型,可以从任何输入创造任何东西。" 这句定义是有分量的。直到本周,生成式 AI 的主流范式是专业化分工——Sora 做视频、Imagen 做图像、AudioLM 做音频、Gemini 做对话。Omni 不接受这个分工。一个模型,所有模态,双向打通。
下面是完整画像:哪些是真的、哪些还没确认、哪些平台已经能用、对正在做 AI 视频生产的人意味着什么。
Gemini Omni 是什么?
Gemini Omni 是 Google DeepMind 推出的新模型家族名称。当前可用的变体是 Gemini Omni Flash——这是 Google 在 Gemini 家族里标识低延迟优化层的命名惯例(之前 Gemini 2.5 Flash、Gemini Nano Flash 都用了同样的后缀)。Pro 或 Ultra 级别从命名上看应该存在,但目前还没公布。
定义性的技术主张写在官方 tagline 里:"a model that can create anything from any input — starting with video." 仔细读,这里有两个独立信息。
第一个,"从任何输入创造任何东西":Omni 接受文本、图像、视频和音频(语音参考已经支持,其他音频类型"即将到来",引自发布博客)。多模态输入并不新——Gemini 1.5 两年前就接受视频和音频作为输入。
第二个,"先从视频开始":Omni 生成视频是原生的、今天就有的能力。图像和音频输出被明确标为未来能力("in time we will support")。所以发布日的不对称是真实的——任何输入进去,视频出来。"anything in, anything out" 描述的是架构野心,不是 2026 年 5 月 22 日你能做的事。
Kavukcuoglu 的发布文章列出了模型上线时驻留的平台:
- Gemini App——对 AI Plus、AI Pro、AI Ultra 订阅用户开放。
- Google Flow——Google 的电影制作工具,Omni 在这里取代或增强了之前基于 Veo 的管线(发布文章没明确说是哪种关系)。
- YouTube Shorts——在 Shorts 创作流里免费使用。
- YouTube Create App——专门的短视频创作 App,也免费。
- 开发者 + 企业 API——"未来几周内"上线。
这就是当前的全部分发面。截至发布日没有 Vertex AI 的 Gemini Omni Flash endpoint,没有 Google AI Studio 开关,也没有任何第三方平台集成——包括 ImagineToVideo(我们正在密切跟踪 API 上线时间)。这一点稍后再展开。
"任意输入、任意输出"今天究竟意味着什么?
读懂 Omni 最清晰的方式是把它画成矩阵。这是发布日的状态,直接来自 Google 官方原文:
| 输入 → | 文本 | 图像 | 视频 | 音频 |
|---|---|---|---|---|
| 输出:视频 | ✅ 已上线 | ✅ 已上线 | ✅ 已上线(剪辑) | ✅ 语音参考已上线,其他"即将" |
| 输出:图像 | 🕗 "假以时日" | 🕗 "假以时日" | 🕗 "假以时日" | 🕗 "假以时日" |
| 输出:音频 | 🕗 "假以时日" | 🕗 "假以时日" | 🕗 "假以时日" | 🕗 "假以时日" |
所以发布日"视频输出"那一行每个格子都是已上线或部分上线,其他每一行都是承诺。除非 Google 上线了图像和音频输出,否则实务上"Omni" 等于"任意输入 → 视频",这也是个有分量的主张——还没有任何公开模型做到这个矩阵。
几个 Google 没有在发布日披露的细节值得标出来:
上下文长度。 发布博客没说输入视频可以多长、prompt 最长多少。Veo 3 发布时是 ~8 秒输出;Sora 2 Pro 层级到 25 秒。Omni 的最大片段长度和最大输入长度在公开材料里还是 TBD。
Benchmark。 发布文章里没有公开质量基准、没有 ELO 排名、没有任何对 Veo、Sora 或其他对手的正面对比数字。Google 没主张 Omni 击败了谁。这是个值得标记的"沉默"——历史上 Google 在有优势数字时通常会在发布当天就放出来,所以这次的沉默是暗示性的,不是结论性的。
单次生成的价格。 YouTube Shorts 免费;Gemini App 走 AI Plus / Pro / Ultra 订阅 gate,方式跟 Gemini 2.5 一样。每秒积分成本还没公开,要等 API 上线时一起出。
分辨率和帧率。 没说。Veo 3 是原生 1080p、部分 4K 路径;Kling 3.0 是原生 4K 60fps;Sora 在下线前只到 1080p。Omni 的分辨率天花板不在发布材料里。
这是一份发布公告,不是一张 spec sheet。把上面的数字视为已知的未知数——未来几周 Google 跟 API 一起放出文档时会逐个填补。
发布日演示的五项能力
发布文章和 DeepMind 模型页一起展示了五个不同的能力类别。每一项都值得单独理解,因为它们对应不同的生产工作流。
1. 用自然语言指令做视频编辑。 Omni 可以接受现有视频片段作为输入,然后修改它——改物体颜色、换动作、改灯光、换主体后的环境。发布页的 demo 是一个原始片段被文本提示渲染成几个视觉上完全不同的变体。架构上的意义是你不需要单独的 inpainting 模型、单独的 relighting 模型、单独的背景替换模型。一个模型,一个 prompt,一次渲染。
2. 把物理仿真当作视频任务。 Omni 的 demo 包括弹珠在轨道上的运动轨迹、流体动力学和其他物理交互的视频化呈现。这跟 Sora 2 和 Veo 3 主打的方向是同一类——把物理真实度作为可测的模型质量轴。Google 没公开任何数值"物理分数",但 demo 的选材清楚地表达了立场。
3. 把复杂概念可视化。 发布页展示 Omni 渲染抽象或难以可视化的概念——英文字母表的结构、蛋白质折叠序列、数学概念。这更接近教育用例而非电影用例,而且是 Veo 和 Sora 都没有重点推过的方向。
4. 多模态参考融合。 你可以同时给 Omni 一个风格参考(一张图)、一个动作参考(一段视频)和一段文本 prompt,输出会融合三者。Style transfer 和 motion transfer 作为独立模型已经存在多年(比如 AnimateDiff、ControlNet);Omni 把它们坍缩成单一模型上的 prompt 参数。
5. 数字化身视频生成。 发布 demo 包括 avatar 风格的输出——保持身份在多帧间一致的角色视频。这一项跟 Kling V3 Omni 的 reference-to-video 能力和 Veo 3 的身份锁定主体功能有重叠,但 Google 的描述把 Omni 描绘得比两者都灵活:任意参考、任意时长、任意模态。
每一项的发布示例都比较短——通常几秒——而"宣传片"的框架让你很难知道生产环境下的失败模式长什么样。不要把 demo reel 当作保证。把它视为 Google 精心挑选 prompt 和 seed 时所能达到的上限。
现在可以在哪些平台用 Omni?
四个入口、三种定价模式,一个一致的限制("API 还要等几周")。逐个看:
Gemini App(AI Plus / Pro / Ultra)。 这是探索 Omni 最深的入口。完整对话式界面——文本、图像、语音参考、多轮调整——围绕模型运转。AI Plus 是入门级;AI Ultra 是生产级。如果你要测试 Omni 能为你具体用例做什么,就在这里测。
Google Flow。 Flow 是 Google 的电影制作工具——之前 Veo 作为底层生成器存在的同一个产品。Omni 在 Flow 里取代或增强 Veo(发布文章没具体说)意味着任何拥有 Flow 访问权的人已经拥有 Omni 访问权。Flow 的编辑器界面——时间轴、镜头控制、画面一致性——比 Gemini App 的对话界面更生产化。做长片或多镜头工作时,Flow 是合适的入口。
YouTube Shorts。 免费。这是惊喜——YouTube 创作者在上传时就能在 Shorts 创建流程里用上 Omni。Google 在这里的具体 UX 在发布文章里没完整文档化;可以预期之前走 Dream Screen 或基于 Veo 管线的生成 prompt、remix 操作、text-to-Short 流程,今后都会切到 Omni。对做 60 秒竖屏内容的创作者,这是最便宜的尝试方式——不用付费、没有 waitlist。
YouTube Create App。 免费。Google 专门的移动端短视频创作 App,跟 YouTube 主站分开。Omni 功能在这里和 Shorts 并行落地。
开发者 + 企业 API。 还没上线。 文章里写"未来几周"。如果你的生产管线依赖程序化访问——webhook、批量生成、多用户工作流——只能等。我们在密切跟踪,博客 会在 Google API endpoint 开放的同一天更新。
这个分发结构有个实际后果:未来几周内评估 Omni 的唯一规模化方式是通过交互入口——Gemini App、Flow 或 YouTube。自动化基准测试、相同 prompt 下与 Kling V3 或 Veo 3.1 的并列对比、生产环境集成——全都被 API 上线时间卡住。
价格与访问层级
发布日的定价格局,从 Google 当前发布的订阅文档和发布博客整理:
| 层级 | 入口 | 价格 | Omni 访问权 |
|---|---|---|---|
| YouTube Shorts | 移动/网页 Shorts 创作器 | 免费 | 包含 |
| YouTube Create App | 移动 App | 免费 | 包含 |
| Gemini App — AI Plus | Gemini 免费层(有速率限制) | 入门价按地区浮动 | 受限 |
| Gemini App — AI Pro | Gemini 付费层 | 订阅制,按地区 | 完整 |
| Gemini App — AI Ultra | Gemini 顶级层 | 高级订阅 | 完整、优先 |
| Google Flow | 与部分 Gemini 层级捆绑 | 绑定 AI Pro / Ultra | 完整 |
| 开发者 API | 未开放 | 单次生成 TBD | "未来几周" |
Google 还没公布 Omni 在 AI Plus / Pro / Ultra 任何层级的单秒积分成本。Gemini App 端的定价模型是订阅打包式、不是计量式——所以在你这一层的月度上限内,可以一直生成,直到打满。
对免费的 YouTube 入口,"免费"是头条,但隐性成本是受限的创作面:YouTube Shorts 是仅竖屏、<60 秒的容器,prompt UI 是为普通创作者而非生产管线设计的。免费很适合尝鲜;不适合做品牌广告交付。
API 定价是任何想基于 Omni 做产品的人最重要的未知数。Google 在过去几代 Gemini 模型的开发者侧定价历史上对标 OpenAI 和 Anthropic 的每百万 token 文本价是有竞争力的;视频按生成计价过去更多变。盯紧 AI Studio 和 Vertex AI 页面——价格会先在那里出现。
Gemini Omni vs Veo 3 vs Sora 2 vs Kling vs Seedance:现在的格局
有意思的问题不是"Omni 好不好",Google 的 demo 看起来是好的。有意思的问题是发布时刻 Omni 在竞争格局里站在哪儿。
截至 2026 年 5 月 22 日,格局如下:
| 模型 | 原生 4K | 最高 fps | 原生音频 | 多模态输入 | 多模态输出 | API 状态 |
|---|---|---|---|---|---|---|
| Gemini Omni Flash | 未披露 | 未披露 | 语音参考 ✅,其他 🕗 | ✅(文本、图像、视频、音频) | 视频已上线,图像/音频"假以时日" | "几周内" |
| Google Veo 3.1 | ✅ 原生 | 24fps | 部分层级原生音频 | 文本、图像 | 仅视频 | 已上线(Vertex AI) |
| OpenAI Sora 2 | ❌ 仅 1080p | — | 原生 | 文本、图像 | 仅视频 | 2026-03-24 下线 |
| Kling Video 3.0 / Omni | ✅ 原生 4K | 60fps | 原生(Omni 变体) | 文本、图像、音频(Omni) | 仅视频 | 已上线 |
| Seedance 2.0 | ❌ 仅 1080p | — | ❌(静音) | 文本、图像 | 仅视频 | 已上线 |
| Runway Gen-4 | ❌ 仅 1080p | — | ❌ | 文本、图像 | 仅视频 | 已上线 |
几个不太显眼的结论。
Omni 真正独特的主张是整个矩阵,不是某个单元格的分数。 列表上其他每个模型都做视频生成。没有一个声称自己是一个单一架构、未来还会同时生成图像和音频。如果 Google 按它暗示的节奏把矩阵剩余部分都上线了,Omni 的卖点不是"最好的视频模型"——而是"一个模型、所有模态、双向打通"。这是结构性主张,不是基准分数主张。
在视频输出这一轴上,Veo 3.1 和 Kling V3 是当下的直接竞争者。 今天如果你要生视频,Veo 和 Kling 是成熟且经过实战检验的。Omni 是新的、分辨率没文档化、被锁在交互入口后面。本月做生产用,Omni 是观察对象,不是工具。
Sora 2 下线是房间里的大象。 OpenAI 在 2026 年 3 月 24 日下线了 Sora 2。这次退役留下的空白正是 Google 在填的。发布时机不是巧合。
4K-60fps 这个格子目前仍是 Kling 独占。 Kling V3 是公开市场上唯一在做原生 3840×2160 @ 60fps 的模型。Omni 的分辨率天花板没公布,我们不知道它是参与这个竞争还是停在 1080p 段。在 Google 表态之前,假设 Kling 4K 模式仍是分辨率领头羊。
原生音频输出是部分支持。 Omni 发布时支持语音参考——意味着你能喂一段语音进去。完整的音频生成与视频同步看起来还在开发中。Kling V3 Omni 和 Veo 3.1 今天就在生成管线里出原生音频(对话、环境音、音乐铺底)。Omni 还没。
2026 年 5 月的竞争解读:Omni 是当下最雄心勃勃的架构、最未经检验的产品,也是 API 跑道最长尚未上线的那个。如果你是为未来 18 个月做企业级采购,Omni 是赌注。如果你本月就要发内容,Veo 或 Kling 是答案。
"Omni"架构为什么对视频生成真的重要
剥掉发布文案,真正的故事是架构层面的。AI 视频的默认心智模型——把视频模型、声音模型、上采样器、唇形同步模型组装成管线——是迄今唯一被规模化交付的方案。管线方案有已知的薄弱点:每一阶段都是质量闸门,误差会叠加,跨阶段会有身份漂移,音视频同步很难因为两种模态是独立生成再后期对齐的。
一个真正统一的架构——内部把图像、视频、文本、音频共同表达的单模型——结构上规避了所有这些失败模式。身份保持一致是因为它不在模型间传递;音视频同步是因为它们一起解码;风格跨帧连贯是因为隐空间是共享的。原理上。
Omni 在生产环境是否兑现这个原理,这是 2026 年 5 月 22 日回答不了的问题。Google 的 demo 暗示能。发布文章"先从视频开始"的措辞也暗示统一架构还没在所有输出模态上完整表达——分阶段交付。真正的证据要靠未来两个季度——API 开放、第三方基准落地、生产环境失败模式浮现。
还有个相关问题:如果 Omni 是架构统一的,它能在每个单模态上压过专用模型吗?不一定。统一模型用广度换深度——每个模态都分到表征预算,没有一个模态独占。Kling V3(仅视频、大量视频训练数据、4K-60fps)这类专用模型,在原始视频指标上可能还会继续领先 Omni 一段时间。Omni 的优势不在任何单轴上,而在你不离开模型就能做的事的广度。
对生产搭建者来说,这是值得跟踪的问题:Omni 的架构优势能否抵消相对专用模型的单模态质量差距?答案完全取决于工作负载。对一个用混合 prompt、参考图、临时编辑做短视频的创作者——Omni 在便利性上赢。对一个为 TV 广告拍 4K-60fps hero 镜头的品牌——Kling V3 4K 在关键指标上大概率仍赢,直到 Omni 在分辨率上追上来。
开发者什么时候能拿到 API?(以及 ImagineToVideo 在盯什么)
发布文章承诺开发者 + 企业 API "未来几周内"上线。Google 还没公布日期、SLA、定价结构或文档 URL。基于此前 Gemini 家族发布的先例——2.5 Flash、2.5 Pro、Nano 家族——从"App 访问上线"到"Vertex AI endpoint 上线"的典型窗口是四到八周。
对 ImagineToVideo 来说,API 时间是闸门。在 Gemini Omni endpoint 走 HTTPS 可达、有 schema 文档和速率限制之前,我们没法把它接进平台。一旦可达,路线图很直白:
- Phase 1(API 第一周): 把 Gemini Omni Flash 作为模型选项加进 text-to-video 和 reference-to-video 流程。定价按 Google 原价 + 我们的标准基础设施开销一对一透传。
- Phase 2: 把 Omni 特有能力——多参考融合、片段内编辑、语音参考输入——作为一等公民控件浮现在生成器 UI 上。
- Phase 3: 与 Kling V3、Veo 3.1、Seedance 2.0 在同样 prompt 集上做并列对比测试,结果发表在这个博客上以保持透明。
订阅 ImagineToVideo 博客 或关注我们的更新——Google API endpoint 开放的同一天我们会发布集成。在这之前,如果你想今天就在已经经过实战检验的模型上做 AI 视频,从 Seedance 2.0 开始做产品镜头、Kling V3 Omni 做电影感多镜头,或 Kling 4K 模式做广播级 hero 镜头。
常见问题
Gemini Omni 是什么?跟普通 Gemini 有什么区别?
Gemini Omni 是 Google DeepMind 推出的新模型家族,与 Gemini 文本/对话主线是不同的产品线。当前发布的变体是 Gemini Omni Flash。核心架构差异是 Omni 从零开始为多模态输入和多模态输出而设计——文本、图像、视频、音频,双向打通——而早期 Gemini 模型虽然接受多模态输入,但是为文本输出专门化的。发布时 Omni 生成视频;图像和音频输出被 Google DeepMind 标为未来能力。
Gemini Omni 是免费的吗?
部分免费。在 YouTube Shorts 和 YouTube Create App 内可以免费用 Omni,这两个入口对创作者都不额外收费。在 Gemini App 内,Omni 被 AI Plus、Pro 或 Ultra 订阅层级 gate 住。独立开发者 API 还没开放;它的定价会在 endpoint 开放时一起公布。
Gemini Omni 什么时候上 ImagineToVideo?
我们在密切跟踪开发者 API 上线。Google 承诺"未来几周内"放出 API。一旦上线,我们的集成时间在天的量级——平台已经具备添加新视频模型的基础设施,Omni 会在 endpoint 开放后很快出现在 text-to-video 和 reference-to-video 流程里。订阅博客 获取集成公告。
Gemini Omni 跟 Veo 3 有什么区别?
Veo 是 Google 上一代视频模型,也是 Omni 上线前 Google Flow 的底层引擎。Veo 接受文本和图像输入并生成视频,部分层级含原生音频。Omni 宣称的野心更宽:任意模态输入、任意模态输出。今天实务上两个都生视频,分辨率、帧率、音频输出的具体差异还在确立中。在 Google Flow 内 Omni 看起来是取代或增强 Veo 的角色——发布文章没把分界画清楚。
Gemini Omni 会取代 Sora 吗?
Sora 2 在 2026 年 3 月 24 日下线了,所以不是直接对比。Sora 2 退役前的部分生产工作流迁移到了 Kling V3 和 Seedance 2.0;Omni 现在是这些工作流的第三个迁移目标。Omni 能否成为事实上的替代取决于 API 定价和质量相对现有方案落到什么位置。
Gemini Omni 支持中文 prompt 吗?
Gemini 的文本编码器已经支持中文(以及几十种其他语言)若干代。发布文章没明确列出 Omni 的 prompt 接口支持哪些语言,但架构血统暗示多语言覆盖是广的。用 Gemini App 拿你的具体语言测一下——这是最快的确认方式。
Gemini Omni 能用于商业用途吗?
Omni 输出的授权条款按你使用的入口默认条款走。YouTube 输出按 YouTube 商业条款;Gemini App 输出按 Google AI Plus / Pro / Ultra 条款——一般允许商业使用,对模型生成内容有常规警告。企业或大体量商业生产用途,等 API + 企业层级——那里条款会明确为生产部署而写。
Gemini Omni 是 Gemini 3 吗?
不是。Gemini Omni 是自己的模型家族、自己的命名线(Flash 已发布,Pro/Ultra 暗示但未公布),与 Gemini 对话主线并行。Google 没说明 Omni 的训练跟假想的 Gemini 3 是什么关系,发布材料把两者当作独立产品线。
总结
Gemini Omni 是今年任何人在 AI 视频领域下的最雄心勃勃的架构赌注。一个模型、所有模态、双向打通的承诺,跟 2024 和 2025 年定义的"管线"方案是结构上不一样的。如果 Google 按它暗示的节奏把矩阵剩下的部分——图像输出、音频输出、更长上下文——都上线,"我用哪个 AI 视频工具"这个心智模型整个会被重写。
承诺是 2026 年 5 月 19 日的新闻。证据是"几周内"的 API 发布,以及之后几个月的第三方基准测试。今天把 Omni 当作观察对象,不是工具。Kling V3、Veo 3.1、Seedance 2.0 仍是本月生产工作的正确答案——它们文档齐全、定价清楚、已集成、规模化运行。
对本周就要发内容的人:继续用现在能用的。对为未来 18 个月做规划的人:订阅 API waitlist,盯紧 AI Studio 和 Vertex AI 文档,安排一个能在 endpoint 开放当天就跑并列基准的季度。
如果你想在 Omni 上线前就在已经经过实战检验的模型上做 AI 视频:
→ 用 Seedance 2.0 做快速产品片段和参考片段(5 秒约 1 美元,720p)
→ 用 Kling V3 Omni 做电影感多镜头 + 原生音频(多镜头序列、唇形同步)
→ 用 Kling 4K 模式做广播级 hero 镜头(原生 3840×2160 @ 60fps)
Google API endpoint 开放的同一天,我们会在 ImagineToVideo 上线 Gemini Omni 集成。在那之前——关注这个博客,继续做内容。